S/W 비용 추정(cost estimation)의 정의
- S/W 시스템을 개발하기 위해 필요한 노력을 예측하는 프로세스
- S/W 개발 비용의 대부분은 工數(person-month)로 표현되는 인간의 노력(effort). 대부분의 추정 기법은 여기에 초점을 맞춤.
S/W 비용 추정의 중요성
- 개발자 및 고객 모두에게 매우 중요(critical) : RFP, 계약, 스케줄링, 모니터링, 제어 모두에 사용
- 전체 비즈니스 계획에 따라 개발 프로젝트를 분류하고 우선순위를 설정을 도움
- 프로젝트에 어떤 리소스를 투입할지, 해당 리소스가 어떻게 잘 사용될지를 결정
- 변화와 재계획 지원의 영향을 평가
- 프로젝트의 관리와 제어가 용이해짐
- 고객은 추정된 비용 내에 실제 개발 비용을 기대
S/W 비용 추정의 결정 사항
- 노력(effort; 일반적 척도는 工數)
- 프로젝트 기간(일반적 척도는 calendar time)
- 비용(일반적 척도는 원/달러)
- 대부분의 추정 모델이 결정하고자 하는 대상은 노력. 노력은 프로젝트 기간과 비용으로 환산됨
잘된 s/w 비용 추정의 특징
- 이해성: 비용 추정이 프로젝트 관리자와 개발 팀에게 이해되고 지원됨
- 현실성: 모든 이해관계자에게 현실적임을 인정받음
- 신뢰성: 믿을 만한 기반 위의 잘 정의된 S/W 비용 모델에 기초
- 경험으로 구축된 데이터베이스: 해당 프로젝트와 관계된 프로젝트의 경험(비슷한 프로세스, 환경, 기술, 사람 및 요구사항 등)에 녹아 든 데이터베이스에 기초
- 세부 항목 정의: 세부 항목이 충분히 정의되어 있어, 주요 위험 영역이 식별되고 성공 가능성이 확실이 평가되어있음
추정의 어려움 : 개발에 있어 가장 어려운 부분 중 하나
- 비용 측정에 관한 역사적 DB의 부재
- S/W 개발은 여러 인자가 밀접히 관계됨. 이들 인자는 개발 노력 및 생산성에 영향을 주며, 이들간 관계는 잘 알려지지 않음
- 훈련된 추정가의 부재
- 부실한 추정에 대해 패널티가 거의 없음
추정 프로세스
비용 추정은 계획 프로세스의 주요 부분
- 프로젝트 관리자는 전반적 기능성, 크기, 프로세스, 환경, 사람, 품질 특성을 개발
- 전체 노력과 스케줄에 대한 거시적 수준의 추정은 S/W 비용 추정 모델을 사용하여 개발됨
- PM은 추정된 노력을 TOP-LEVEL의 WBS(Work Breakdown Structure)로 나눔. 또한 스케줄을 주요 이정표(milestone) 일자로 나누고, 프로젝트 계획을 함께 이루는 스탭의 프로파일을 결정
실질적 비용 추정 프로세스는 7단계로 나뉨
- 비용 추정 목표 수립
- 필요로 하는 데이터와 리소스를 위한 프로젝트 계획을 생성
- S/W 요구사항 fix
- S/W 시스템 설계를 실행 가능한 수준으로 상세화
- 여러 독립적 비용 추정 기술을 사용하여 추정 기법 개개의 장점을 취합
- 추정 결과치를 비교 및 추정 프로세스 반복
- 프로젝트가 시작된 후에는 실제 비용과 진행 및 프로젝트 관리 결과 피드백을 모니터링
추정 시 주의 사항
- 추정 범위(모델의 추정 가능 범위에 주의. 전체 생명주기를 지원하는 모델도 있는 반면 요구사항 단계만 추정할 수 있는 모델도 존재)
- 모델의 단위(calibration)와 가정
- 각기 다른 모델 parameter에 따른 추정 결과의 민감성
- 실제 비용에 대한 추정의 편차
S/W 크기 측정
S/W 크기는 S/W 비용에 가장 큰 영향을 주는 인자. 실전에서 주로 5가지의 S/W 크기 척도가 사용되는데, 이중 LOC와 FP가 가장 많이 사용됨
LOC(Line Of Code)
-
S/W에 대한 인수된 소스 코드의 라인 수로서, 주석과 공백 라인은 counting에서 제외.
-
프로그래밍 언어에 종족적임에도 불구하고, S/W 크기 측정에 가장 광범위하게 사용.
-
대부분의 모델이 S/W 비용 산정에 본 척도를 사용.
-
정확한 LOC는 프로젝트가 완료된 이후에야 산정 가능. 실제 빌드 전에 LOC 크기 예측은 프로그램의 비용 추정 만큼이나 어려움
-
코드 크기 추정의 전형적 방법 : 전문가의 판단과 함께 PERT 기법 사용
-
PERT 공식
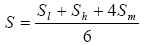
- Sl: 최소 가능 크기, Sh: 최대 가능 크기, Sm : 가장 근접한 크기
- 각각의 component에 대한 크기를 측정 후 합산하여 전체 S/W 시스템의 크기를 측정하기도
S/W science
-
Hastead에 의해 코드 길이(code length)와 볼륨(volume) 척도로 제안됨. 코드 길이는 소스 코드 프로그램 길이를 측정하기 위해 사용되며 다음과 같이 정의됨
N = N1 + N2 (N1: 전체 연산자 개수, N2 전체 피연산자 개수)
-
볼륨은 필요 저장 공간의 양에 대응되며 다음과 같이 정의됨
V = N * log(n1 + n2) (n1 : 각기 다른 연산자의 개수, n2 : 각기 다른 피연산자의 개수)
-
내부 이론에 대한 논쟁으로 인해, 최근에는 잘 사용되지 않음
Function Points(FP)
-
프로그램의 기능성에 기반한 측정 단위. FP의 전체 점수는 아래 다섯 개의 각기 구분되는 형식의 점수 합산에 따름.
- User-input types(EI) : 데이터 또는 제어 사용자 입력 타입
- User-output types(EO) : 시스템에서 사용자에게로 나가는 산출 데이터 타입
- Inquiry types(EQ) : 응답을 얻기 위한 대화형 입력(interactive input)
- Internal file types(ILF) : 시스템 내에서 사용되고 공유되는 논리적 정보 집합(group)
- External file types(EIF) : 시스템 간에 주고받고 공유되는 파일.
-
이들 각각의 타입에는 세 가지의 복잡도 수준(complexity level. 1: simple, 2: medium, 3: complex) 값이 할당됨과 동시에 (3 ~ 15)까지 달라지는 가중치가 주어짐
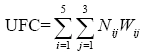
UFC(Unadjusted Function-point Counts). N과 W는 각각 값과 가중치를 뜻함. i는 타입의 종류, j는 복잡도. 어떤 프로젝트의 function-point count가 2개의 simple input(W = 3)과 2개의 complex output(W = 7)이고 1개의 internal file(W = 15)일 경우, UFC는 2 * 3 + 2 * 7 + 1 * 15 = 35 임.
- 초기 Function-point Count는 비용 추정에 직접 사용되거나, 프로젝트의 전체 복잡도에 따른 인자 값에 의해 수정됨.
- 인자 값은 분산 프로세싱의 정도, 재사용 코드의 양, 요구사항의 성능 등이 고려됨
- 최종 Function-point Count는 UFC에 복잡도 인자(complexity factor; VAF: value added factor) 값의 곱. AFP = UFC * VAF
- UFC는 코드 크기 추정에 사용되기도. LOC = a * UFC + b (a, b는 선형 회귀와 이전에 종료된 프로젝트 데이터를 통해 얻음)
Extensions of function point : Feature point
- FP를 확장하여 새로운 종류로 알고리즘을 추가.
- 알고리즘은 중요 계산 문제를 풀기 위해 완전히 표현되는 규칙의 집합으로 정의됨
- 각각의 알고리즘에는 1 ~ 10까지의 가중치가 주어짐. 나머지 계산은 기존의 FP에 가중치가 적용된 각각의 알고리즘 타입 값의 합산
- FFP(Full Function Point) 역시 FP 확장의 일부로서, 2개의 data function control 타입과 4개의 control transactional function 타입을 추가
Object points
- Feature point나 FFP와는 달리, FP와는 다른 각도에서 개체 포인트를 측정
- screen, report, 3GL component 등의 개체 개수 및 복잡도에 기반하여 측정
- 가중치는 1(단순 screen) ~ 10(3GL component)으로 이후 계산은 FP와 동일
- 개발 생명 주기의 초기 단계에서 사용이 간단하고 S/W 크기를 합리적으로 측정하므로, COCOMO II와 같은 비용 측정 모델에서 주된 측정 모델로 사용됨.
비용 측정(cost estimation)
-
비용 측정의 종류는 측정 방향 또는 알고리듬 사용 유무로서 구분 가능함. 측정 방향에 따른 구분으로,
-
상향(Bottom-up)
- 각 component를 먼저 추정하고 그 결과를 합하여 전체 시스템의 추정 결과를 얻음.
- 초기 설계 및 시스템이 어떻게 각 component로 나뉘었는지를 알아야 할 선결 조건이 있음
-
하향(Top-down)
- 상향 기법과 반대. 모든 비용 추정은 전역 속성으로부터 도출됨
- 알고리즘 방식과 비 알고리즘 방식 모두가 사용됨
- 초기 단계에서의 비용 추정에 알맞음
비 알고리듬 기반 기법
비용 유추(Analogy costing)
- 측정 대상이 되는 프로젝트와 유사한 하나 또는 그 이상의 프로젝트가 완료되었을 때 사용
- 앞선 프로젝트의 실 비용을 이용하여 측정 대상 프로젝트의 비용을 유추
- 전체 시스템 및 하위 시스템 추정 모두에 사용 가능
- 실제 프로젝트 경험에 기반하여 추정하기에 정확도가 높음
- 앞선 프로젝트에 비해 어떤 사항(제약 조건, 환경, 기능 등)이 확장되었는지가 명확해야.
전문가 판단(Expert judgment)
-
1명 이상의 추정 전문가가 개입. 전문가는 그들만의 방법과 경험을 통해 추정.
-
Delphi, PERT와 같은 전문가의 의견 일치(consensus) 메커니즘을 이용하여 추정 결과의 비일관성을 해결
-
Delphi 기법
- Coordinator는 각 전문가에게 명세와 양식을 주어 추정 결과와 원칙을 기록하게 함
- 각각의 전문가는 독립적으로 추정 결과를 기입. Coordinator에게로의 질문은 허용됨
- Coordinator는 추정 결과 요약(평균과 median 값 사용) 및 추정 원칙과 후속 단계의 전문가 추정 요청 내용이 기입된 양식을 준비
- 2와 3 단계를 적절한 수준에 이를 때까지 반복
파킨슨의 법칙(Parkinson's Law)
- '작업은 가용한 부피에 맞게 채워진다(work expands to fill the available volume)'란 법칙을 이용. 비용은 결정목표 평가가 아닌 가용 리소스에 의해 결정됨(추정이 아님)
- 때로는 좋은 추정 방법이 되기도 하지만, 매우 비현실적 추정 결과로 인해 권장되지 않음. 또한 S/W 공학의 내재적 역량(practice)를 증대시키지도 않음
획득 가능 가격(Price to win)
- S/W는 비용은 프로젝트를 따내기 가장 좋은 가격에 의해 추정됨
- S/W의 기능성이 아닌 고객의 예산에 기반하여 추정됨
- 이 역시 파킨슨의 법칙 기법과 마찬가지로 권장되지 않음(프로젝트를 따내기 위한 억지 추정의 위험 내포)
알고리즘 기반 기법(Algorithmic methods)
- 주요 비용 인자(factor)로 여겨지는 변수들 간의 함수를 통한 비용 추정치를 제공하는 수학적 모델에 기반
- 모든 알고리즘 기반 모델은
의 형식을 취함. (x1, x2… xn은 비용 인자를 뜻함) - 분석적(Putnam, SoftCost) 또는 경험적(empirical) 모델(대부분의 알고리즘 기반 모델)로 나뉨
- 비용 인자(cost factor): 4개의 타입으로 나뉨(product factor, Computer factor, Personnel factor, Project factor)
- 선형 모델(Linear model), 배수적 모델(multiplicative model), 지수적 모델(Power function model; COCOMO81, COCOMO II, Putnam 모델 및 SLIM), 선형 회귀를 이용한 조정 모델(Model calibration using linear regression), 이산 모델(Discrete models) 등이 존재.
- 많은 알고리즘 기반 기법이 제시되었음에도 불구하고, 대부분의 모델 성능이 만족스럽지 못함.
- 한 조사에서는 오직 7%의 추정가 만이 알고리즘 모델을 주된 추정 기법으로 사용한다고.
모델 성능 평가(Measurement of model performance)
- 가장 유명한 오류 측정 기법은 MARE(Mean Absolute Relative Error)
- 비용 평가 모델 평가의 주요 기준 : 정의(definition), 충실성(Fidelity), 객관성(Objectivity), 구조성(Constructiveness), 상세성(detail), 안정성(stability), 범위(scope), 사용성(Ease to use), Prospectiveness, Parsimony 등.
실무자(practitioner)의 추정에 관한 주요 질문 사항 및 전문가 판단 기법
-
어떤 비용 추정 모델을 사용할 것인가?
-
어떤 S/W 크기 측정 단위(measurement)를 사용할 것인가? - LOC, FP, feature point 등
-
어떻게 하면 추정을 잘 할 것인가?
-
실제적으로 가장 광범위하게 사용되는 추정 기법은 전문가 판단(expert judgment) 기법. 하지만 다음과 같은 문제를 드러냄
- 반복 가능하지 않으며, 명시적이지 않은 추정 결과를 냄
- 모든 새로운 프로젝트마다 실력 있는 추정 전문가를 투입하기 어려움
- 비용과 시스템 크기간 관계는 비 선형적. 비용은 크기에 대해 지수적인 증가 추세를 보임. 전문가 판단 기법은 오직 현재의 프로젝트와 (해당 전문가가 추정했던) 이전의 프로젝트가 비슷할 경우에만 적절
- 비용 초과를 피하기 위한 관리에 의한 예산 조정(budget manipulation)은 이전 프로젝트로부터의 경험과 데이터를 의문시되게 만듦.
최신 기법 및 결론
- 최근에는 AI에 기반한 (Neural network 및 CBR 등) 추정 기법이 개발되기도. 또한 COBRA와 같은 hybrid형(전문가 판단 및 양적 프로젝트 데이터에 기반한) 추정 기법이 나타나기도 함.
- 높은 수준의 정확성을 지닌 추정 기법은 없음. 이유는 결국 개발 시스템 환경의 변화임.
- 추정 수준을 높이기 위해서는 프로젝트의 불확실성을 최대한 줄여야.
References
-
Software Development Cost Estimation Approaches – A Survey, Barry Boehm, Chris Abts University of Southern California, Los Angeles, CA 90089-0781, Sunita Chulani, IBM, Research, 650 Harry Road, San Jose, CA 95120
-
Software Cost Estimation, Hareton Leung, Zhang Fan, Department of Computing, The Hong Kong, Polytechnic University {cshleung, csfzhang}@comp.polyu.edu.hk
Comments